免费 AI 图生视频工具
上传一张照片,这个 AI 图生视频工具 30 到 60 秒让它动起来——一个运镜、一阵风、一个看向镜头的动作。照片生成视频,不用剪辑软件,什么都不用装。注册送的积分够你先免费试试。
- 1080p
- 最高分辨率
- 30-60 秒
- 一般耗时
- 无
- 水印
AI 图生视频能做什么
最常拿来让它动起来的几类图。
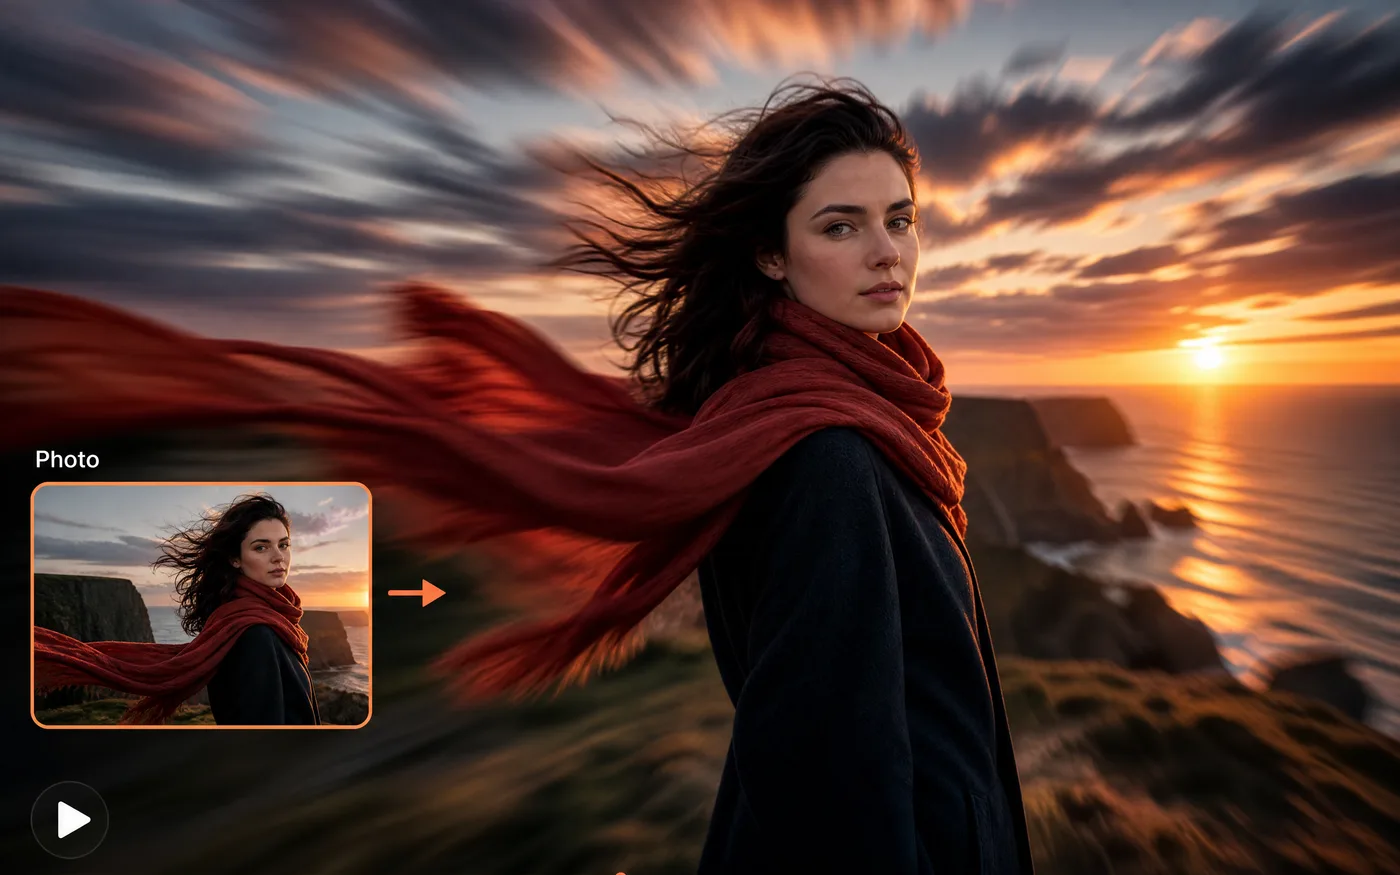
照片生成视频,一键动起来
给人像或风景加上自然可信的动效——云在飘、头发在动、眼睛慢慢眨一下。
- 你的图就是第一帧 — 片子从你那张图开始。
- 轻微或明显 — 动多少你说了算。
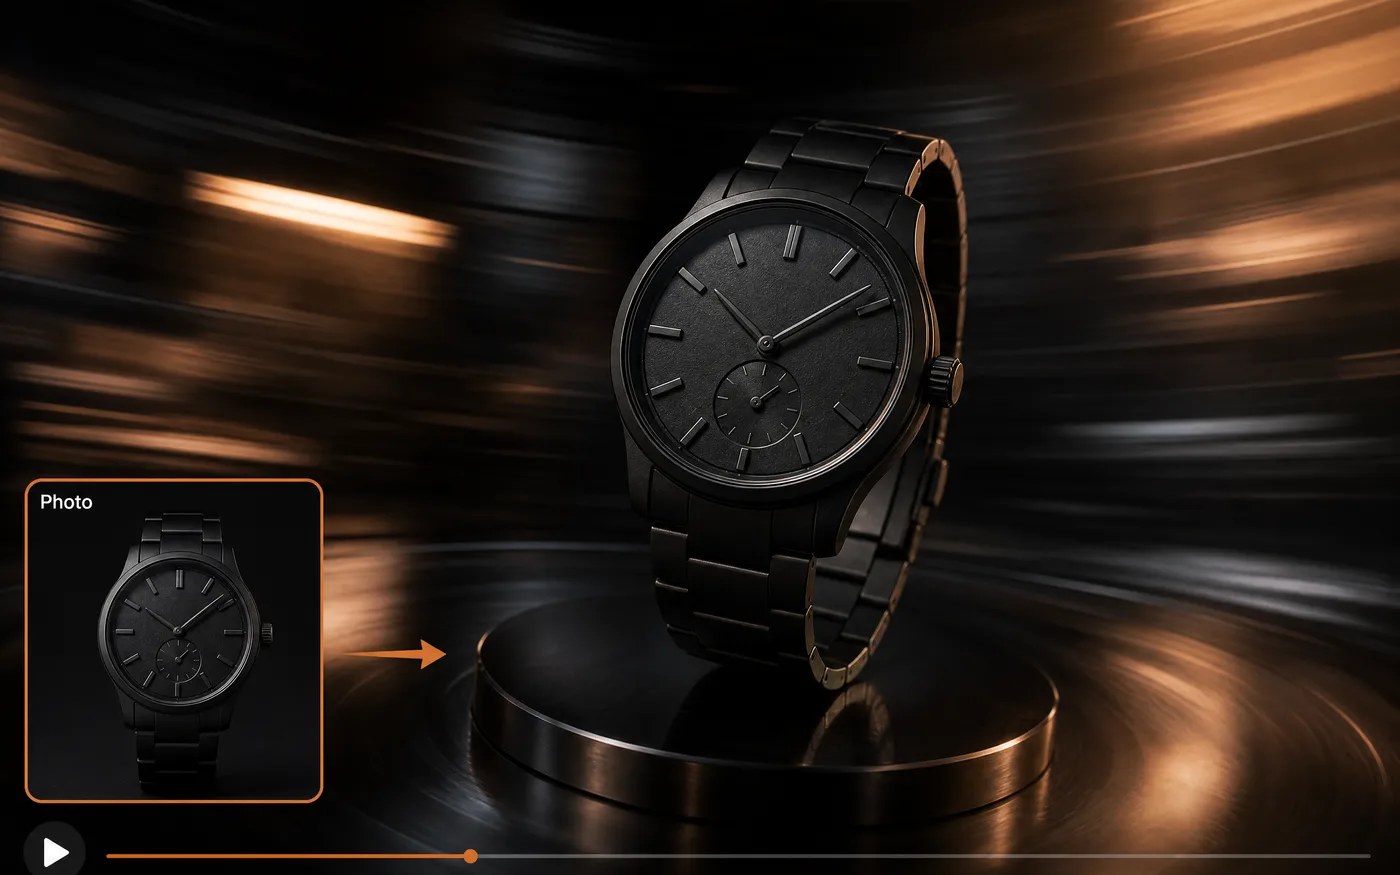
一张产品图做视频
把一张产品照变成环绕、推近或缓慢展示——不用二次拍摄就有了详情页和投放要的动态素材。
- 运镜你说了算 — 环绕、推近、横移、俯仰。
- 一张图多条片 — 同一张图做不同运镜。
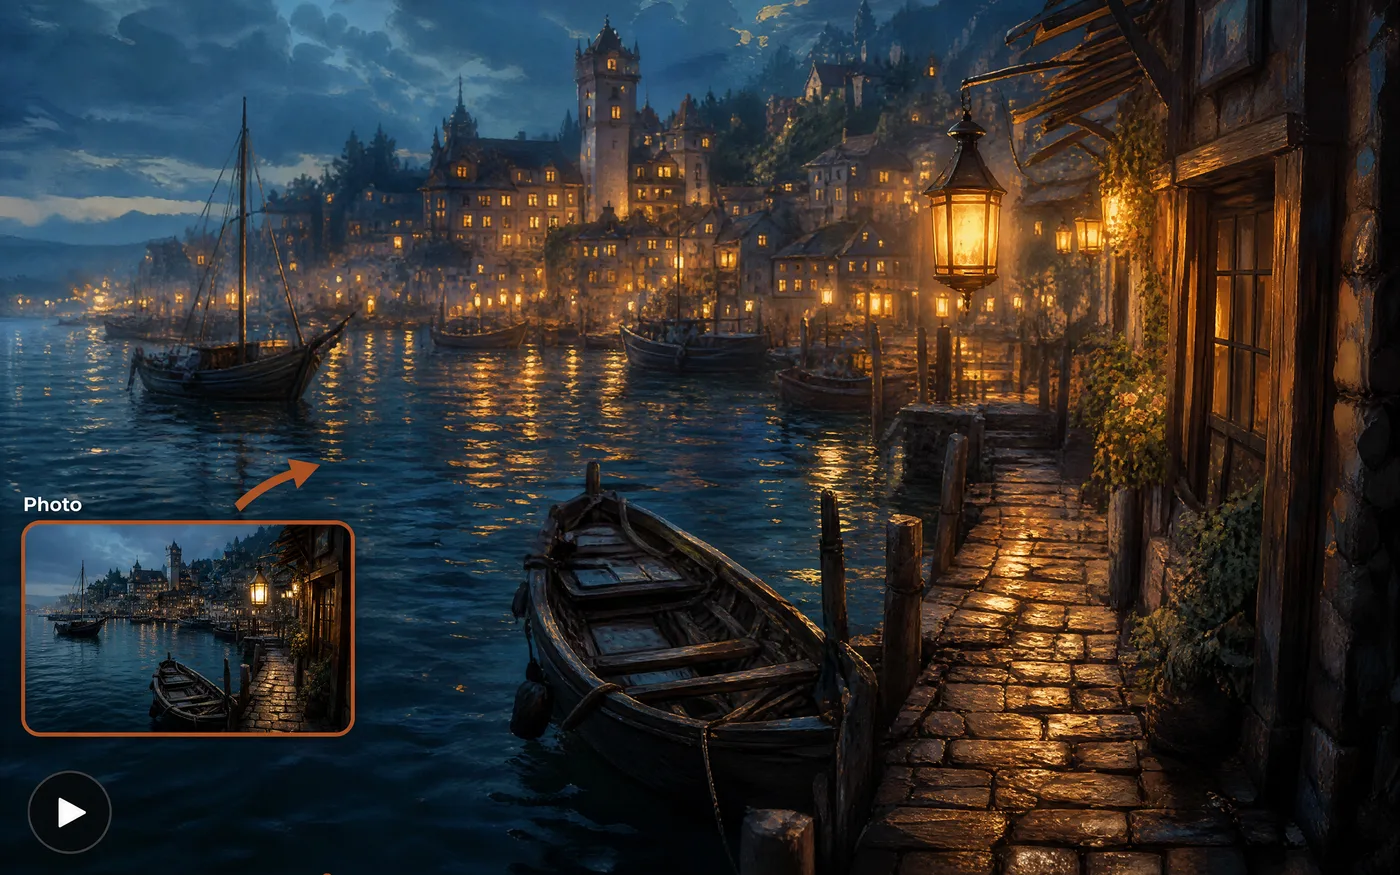
图生视频让插画动起来
给画作、海报或 AI 生成的图加上动效——视差、光线流动、角色重心微微移动。
- 保留你的画风 — 线条和颜色不会在动起来后走形。
- 很适合 AI 出的图 — 刚生成的图直接拿来动。
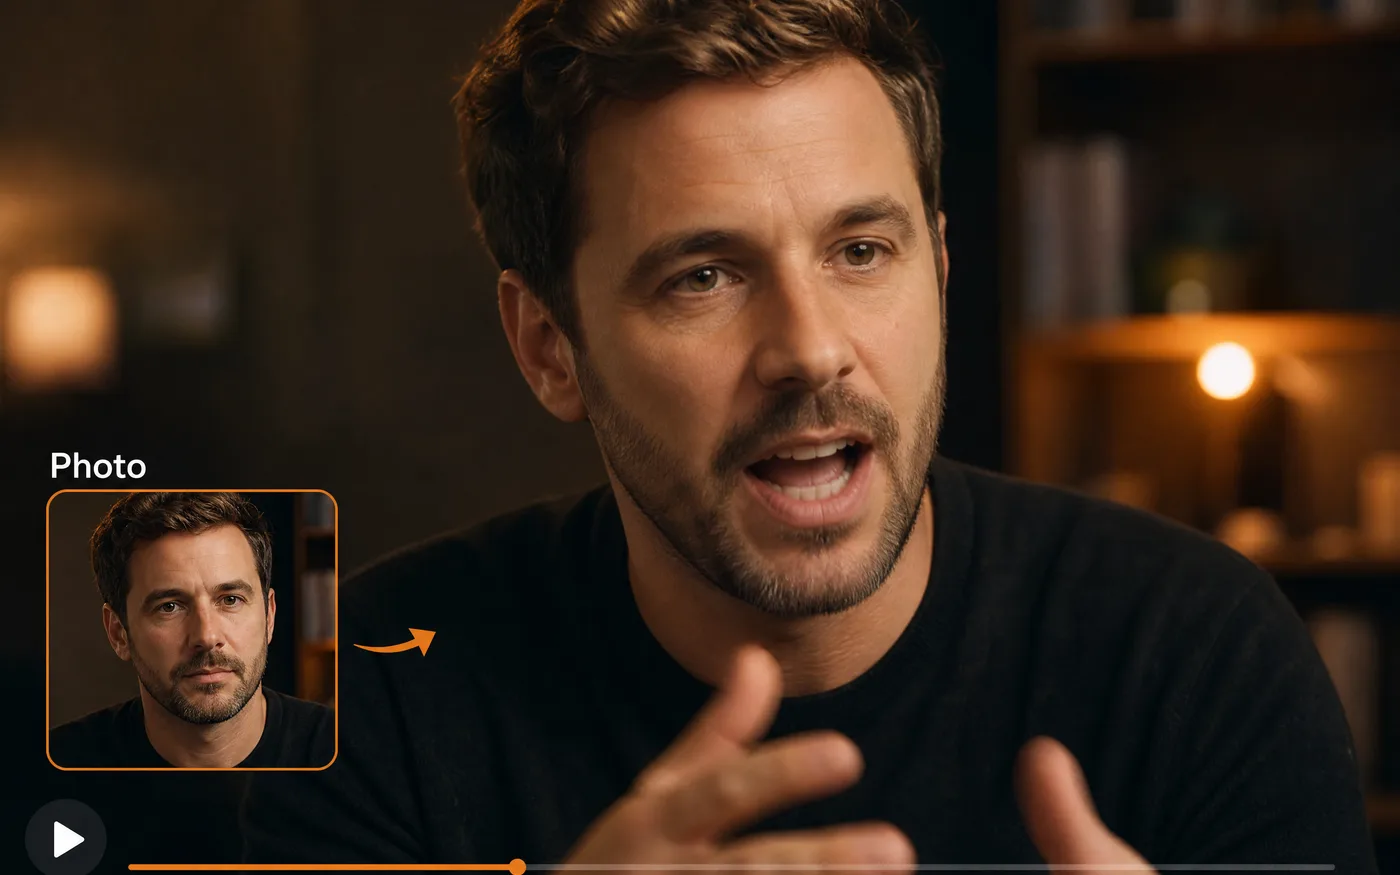
说话和音乐短片
把音频和图片一起上传,得到跟着音频走的片子——会说话的人像,或者一个音乐画面。
- 跟着你的音频 — 动作会跟上传的音轨对齐。
- 设置很简单 — 一张图,一个音频文件。
免费 AI 图生视频工具怎么用
三步做出第一条视频,免费就能开始:
 01
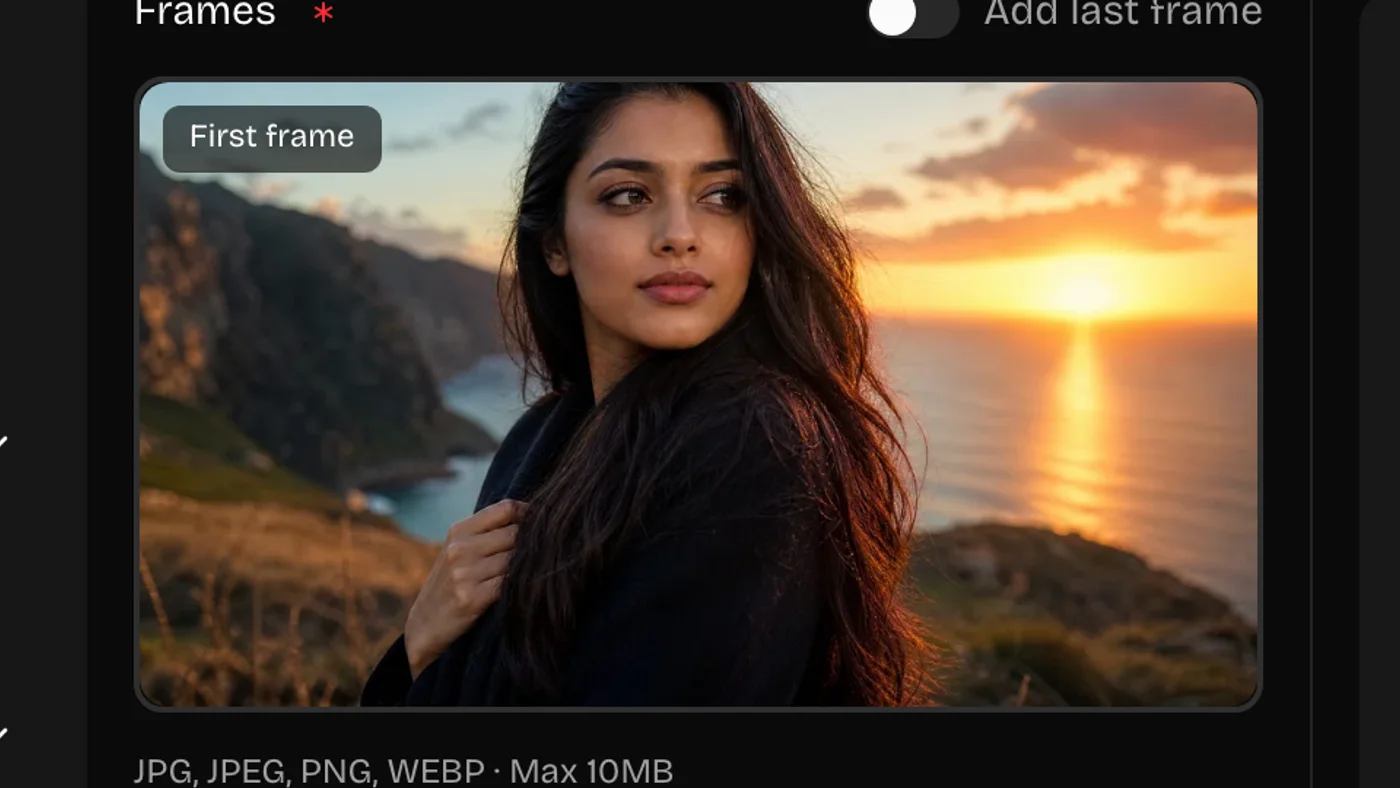
上传照片
放一张 JPG 或 PNG 进来。它会作为第一帧,所以清晰、构图好的图效果最好。
 02
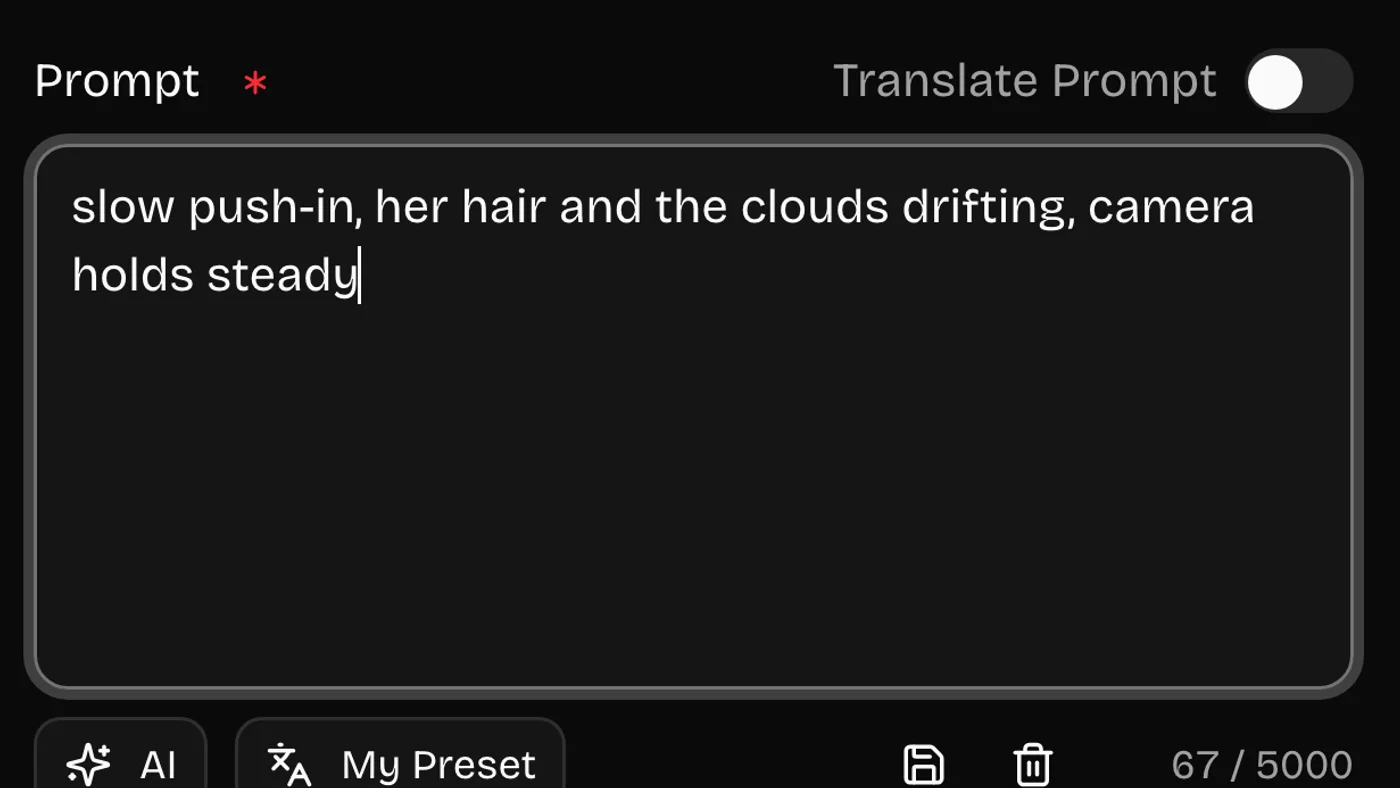
说清怎么动
描述动效和镜头:什么在动、动多快、镜头是缓缓移动、环绕,还是固定不动。
 03
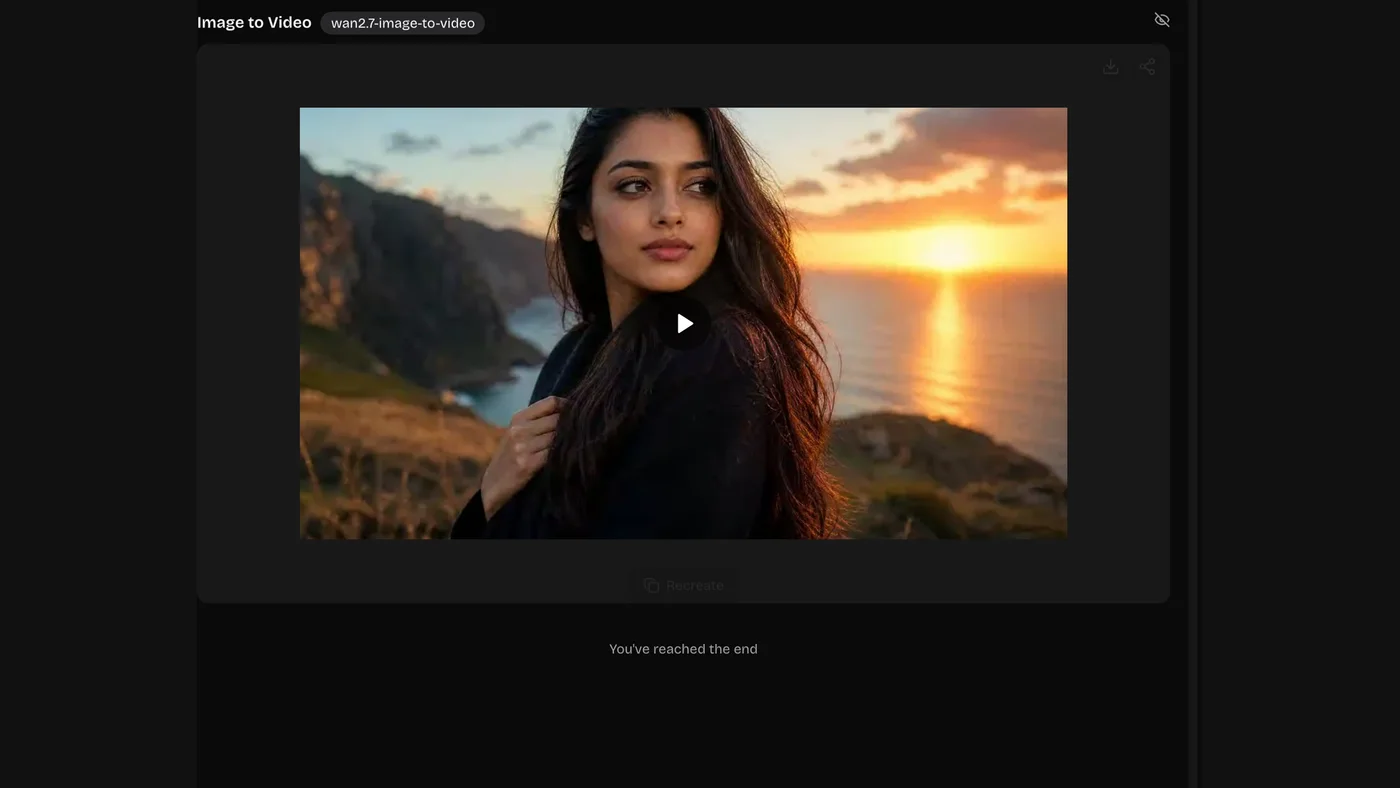
生成并下载
出片、回看、下载 MP4。每条片子都会连着当时的描述留在历史里。
图生视频能用哪些运镜
这里的提示词几乎全在讲怎么动。点名一个动作,画面其余部分让它稳住。
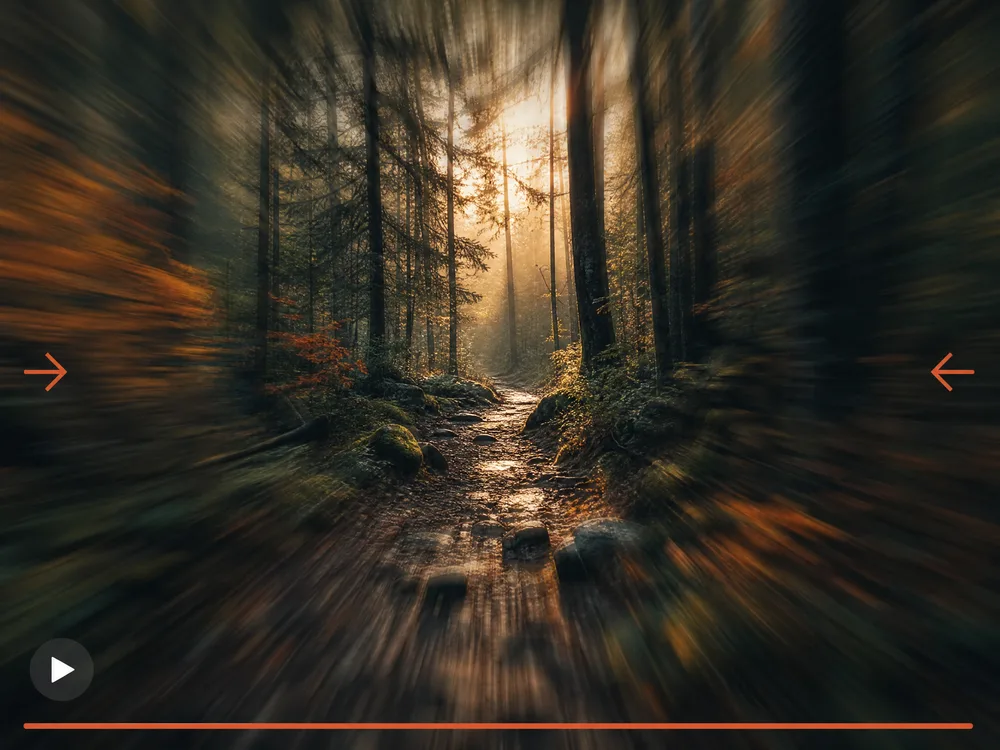
缓慢推近
最稳的一个动作,能出效果又不会把画面搞坏。
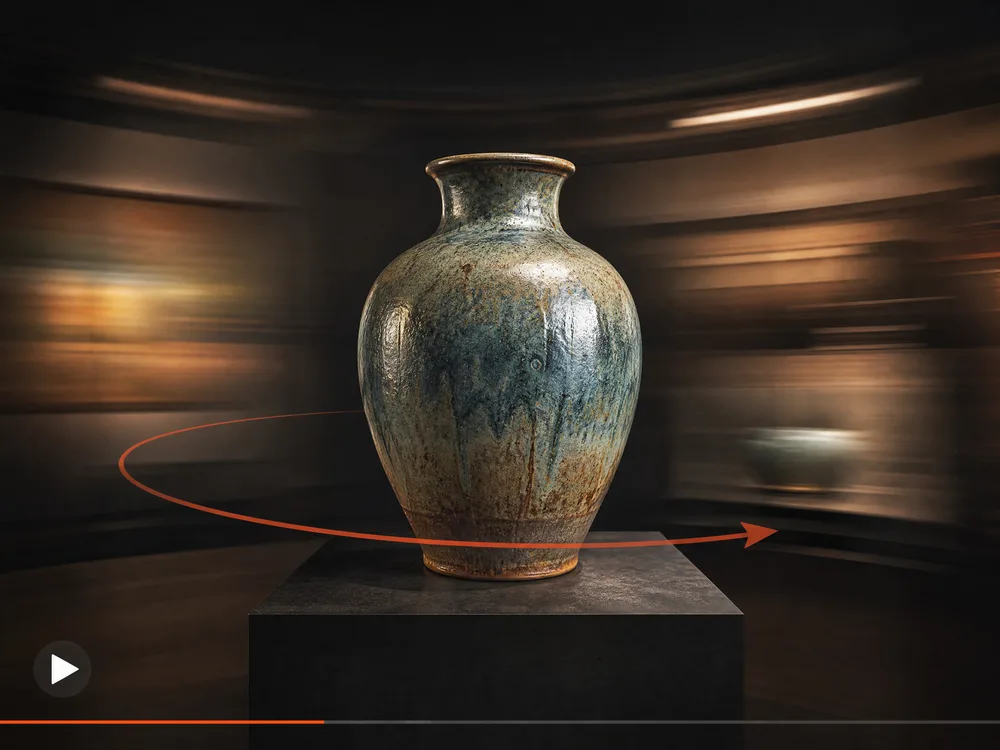
环绕与视差
绕着主体转,背景就和主体分开了。
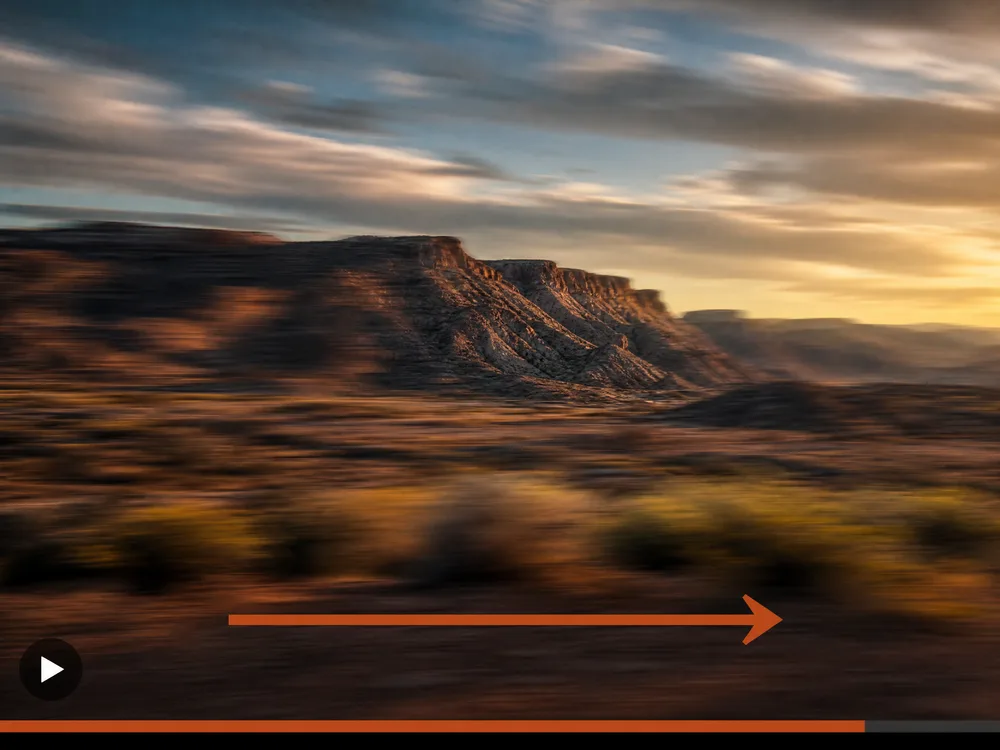
横摇与俯仰
把原来构图之外的东西带出来。
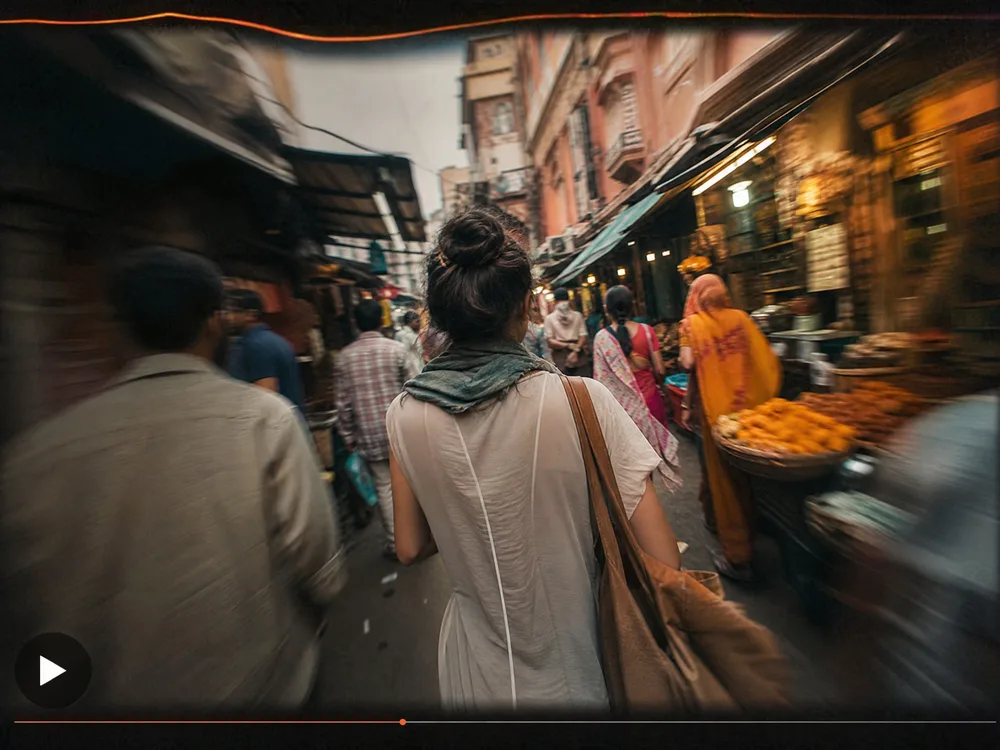
手持轻晃
一点点晃动就像有人真的举着相机。
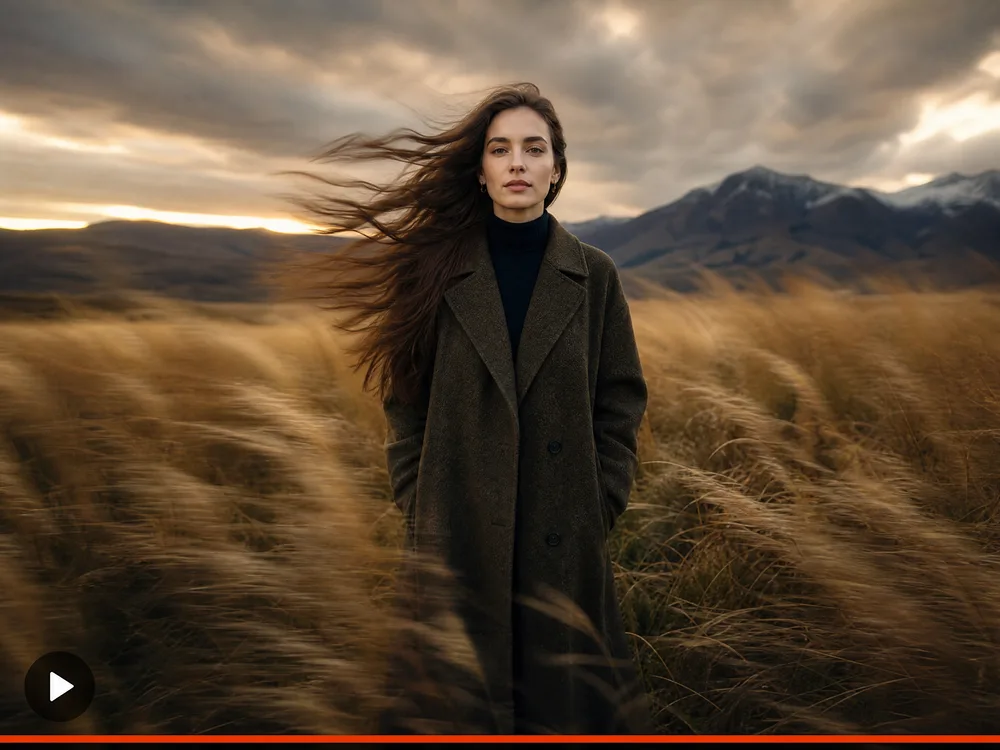
只动主体
相机不动,只让头发、水面或衣料动。
拉远揭示
从特写开始往后拉,让场景自己交代清楚。
图生视频的动效怎么描述
画面长什么样由图片决定,所以你的描述只需要处理一件事:什么在动。
写清这四样就够了
- 1什么在动——主体、背景,还是只有镜头
- 2动多少——轻微飘动还是明显的动作
- 3镜头——固定、慢推、环绕、手持
- 4节奏——缓慢平稳,还是轻快
make it move
Slow push-in on the subject, hair and scarf drifting in a light breeze, background stays still
「动一下」什么都没说。写清什么在动、什么不动,成片才会还像你那张照片。
she turns around and walks away and waves
Subject slowly turns her head towards the camera, everything else holds still
一张静态图撑不起三段动作。一条片子一个清楚的动作,需要连贯流程就多做几条接起来。
cinematic camera motion epic
Camera orbits slowly to the left around the product, steady speed, no cuts
说清镜头往哪边走、多快。「电影感」对模型没有意义。
为什么用我们的照片生成视频工具
任何人都能用一句话让图片动起来——更快、更清晰,也更贴合你原来那张照片。
以你的图为准
你上传的静态图就是第一帧,所以成片始终认得出是你的,不会跑成另一个东西。
不用会做动画
一句话描述动效。不用打关键帧、不用管时间轴,也没有软件要先学。
多个模型,一次上传
同一张图在几个模型上都试试,哪个动得好留哪个,不用来回换网站。
单条成本低
试一个动效想法很便宜。动作满意了,才需要用更贵的模型。
音频驱动
上传音轨,有的模型会跟着它走,一张图就能做会说话的人像和音乐画面。
每一版都留着
每条片子都连着当时的图片、描述和模型留在历史里,满意的那条随时能照原样再跑一遍。
AI 图生视频常见问题
它把一张静态照片变成短视频。你上传图片,描述它该怎么动,AI 就让它动起来——你的图会作为第一帧,所以成片保留你原本的画面感觉。
新账号送免费额度,可以先试再决定要不要付费。之后按需充值或订阅,看你生成得多不多。
清晰、光线好、主体明确的图。太暗、太模糊或画面太杂的图,模型能参考的信息少;细节不足的图上加大幅动效,通常会显得发虚。
每条几秒。想要更长的就多做几张图各自动起来再接到一起——一条片子一个清楚的动作,比一长串流程效果好得多。
可以。有些模型接受上传音轨并跟着它走,会说话的人像和音乐短片就是这么做的。其他模型返回无声视频,可以自己配。
一般 30 到 60 秒。最便宜的模型更快,高精度模型和更长的片子要久一些。
通常是提示词要求的动作超出了单张静态图能支撑的范围。要求少一点——慢慢推近或者轻轻转个头——并让背景保持不动。